 Mirmi
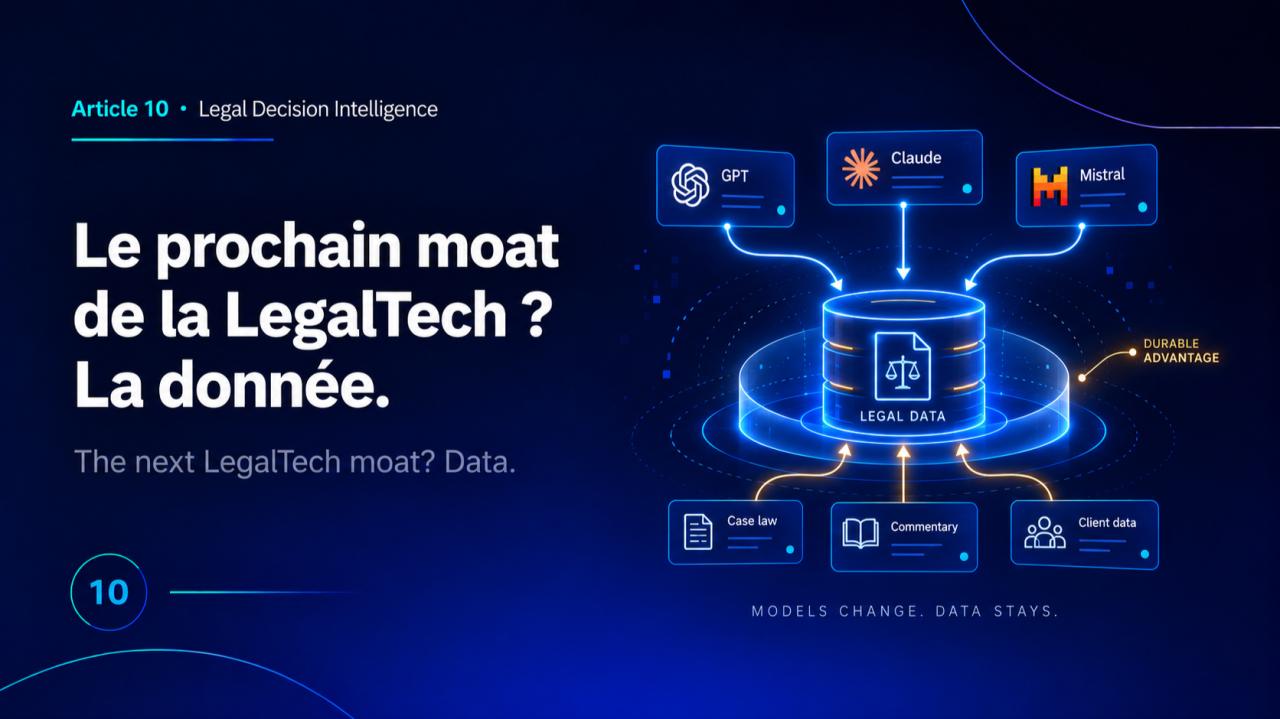
Pendant deux ans, tout le monde a parlé des modèles : GPT, Claude, Mistral, modèles propriétaires… Mais la bataille commence à se déplacer.
Legora veut désormais concurrencer directement Westlaw et LexisNexis sur la recherche juridique. Pour compléter sa base, l’entreprise va jusqu’à scanner des recueils de jurisprudence papier lorsqu’elle ne trouve pas certaines décisions sous une forme exploitable.
Thomson Reuters vient de faire un pari encore plus clair : 40 M$ investis pour entraîner son propre modèle, Thomson, à partir d’une base open source enrichie avec des décennies de contenus Westlaw, Practical Law, Reuters et l’expertise de ses juristes.
Pourquoi investir autant dans la donnée alors que les grands modèles deviennent meilleurs chaque mois ? Parce que le modèle devient de moins en moins rare. La bonne donnée, elle, reste difficile à copier.
Demain, plusieurs LegalTech pourront utiliser le même Claude ou le même modèle open source. Ce qui fera la différence sera ce qu’elles mettent derrière : jurisprudence, commentaires, taxonomies, précédents… puis, de plus en plus, les données propres de leurs clients. C’est probablement là que le marché va se séparer.
Les acteurs historiques ont des dizaines d’années de contenu juridique enrichi. Les nouveaux entrants construisent leurs propres bases. Et une troisième bataille commence déjà : qui comprendra le mieux la manière dont chaque entreprise applique réellement le droit ?
Pour les directions juridiques, ce n’est pas encore un sujet quotidien. Mais cela donne une bonne grille de lecture des outils qui arrivent. Dans quelques années, demander « quel LLM utilisez-vous ? » sera peut-être beaucoup moins intéressant que demander : « Quelles données avez-vous que les autres n’ont pas ? ». Et surtout : « Qu’apprenez-vous de mes données pendant que j’utilise votre outil ? »
Le prochain avantage compétitif des LegalTech ne sera peut-être pas d’avoir une IA plus intelligente. Ce sera d’avoir un patrimoine de données que les autres ne peuvent pas reconstruire.
Cette publication reprend une analyse initialement partagée par Mirmi sur LinkedIn.
Voir sur LinkedIn